En 2026, 73 % des développeurs qui utilisent un assistant ou un agent de code s'en servent tous les jours. Un tiers des utilisateurs quotidiens y passent quatre heures ou plus. Que ce soit dans le navigateur, en CLI, dans l'IDE ou via une API, les moyens d'utiliser un LLM pour programmer sont variés. Mais comment intégrer l'IA dans son environnement sans juste spammer les prompts en croisant les doigts, comme sur une machine à sous ?
Spoiler : la réponse tient moins au prompt qu'au système qu'on construit autour du modèle.
Cette série passe en revue ce qui compte vraiment pour intégrer l'IA au quotidien : contexte, harness, tools, MCP, skills, orchestration… Claude Code servira de fil rouge pour les exemples, mais les concepts restent valables avec d'autres outils agentiques (Codex, Windsurf, Cursor…).
Elle s'adresse aux développeuses et développeurs qui ont déjà utilisé un chat ou une autocomplétion et veulent passer à un agent fiable dans leur projet. Pour rester concret, un même sujet reviendra dans chaque article : ajouter la pagination à la liste des contacts dans un projet iOS. Chaque article illustrera une décision de ce parcours, de la demande à la PR.
Chat ou agent ?
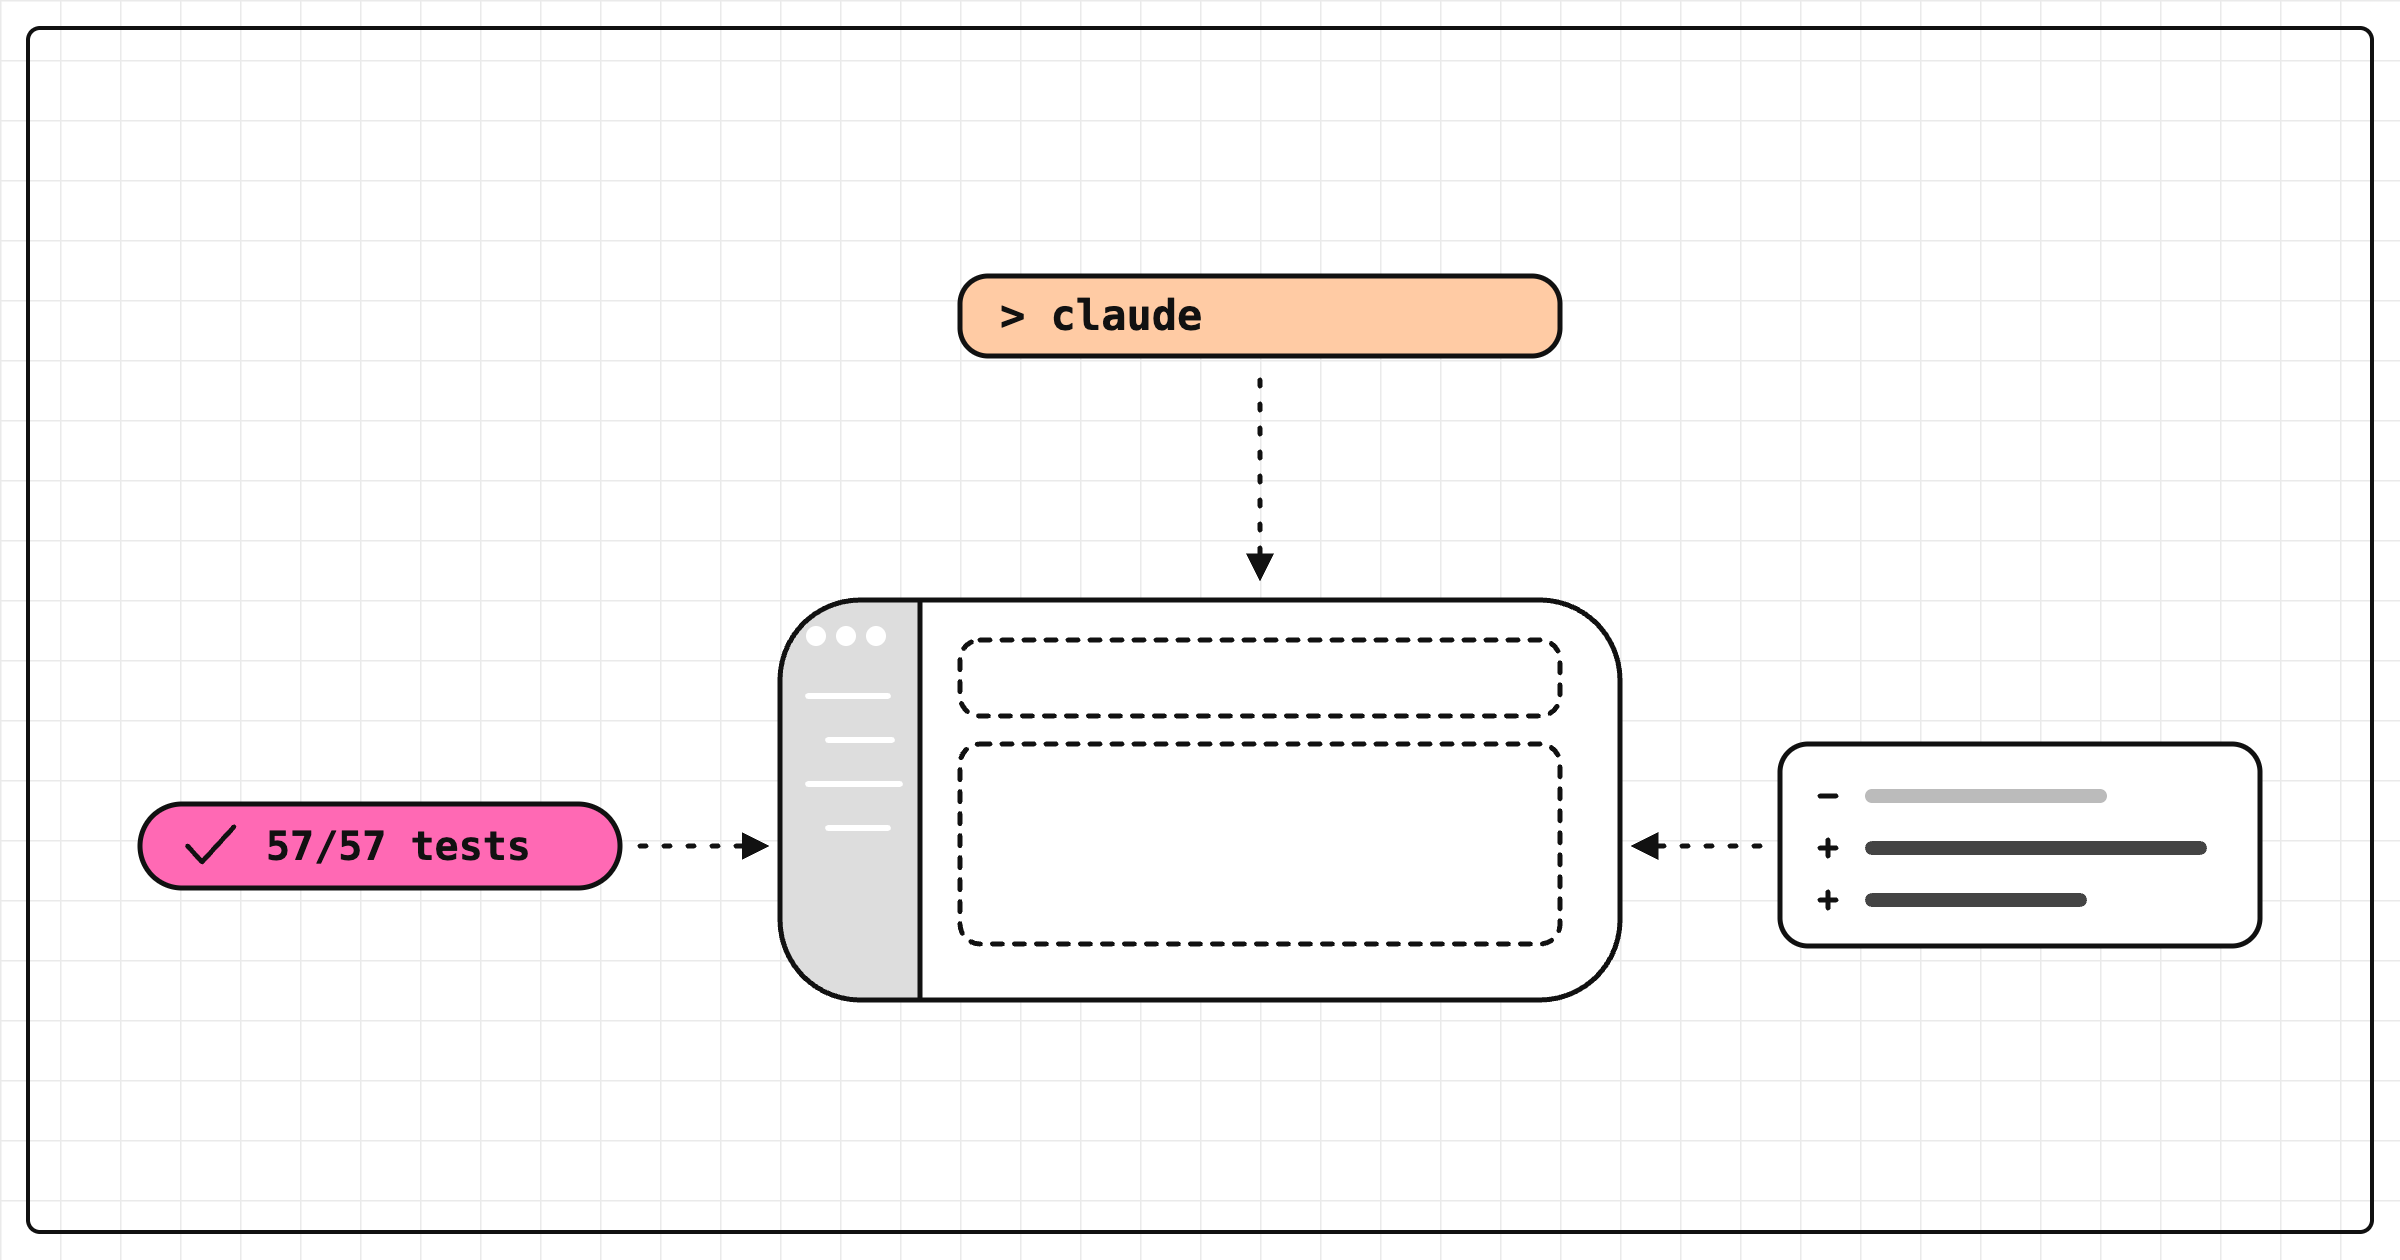
Claude Code, contrairement à un chat, travaille dans le dossier d'où on le lance. Il lit et comprend le code, modifie des fichiers, exécute des commandes, utilise Git, directement dans votre repo.
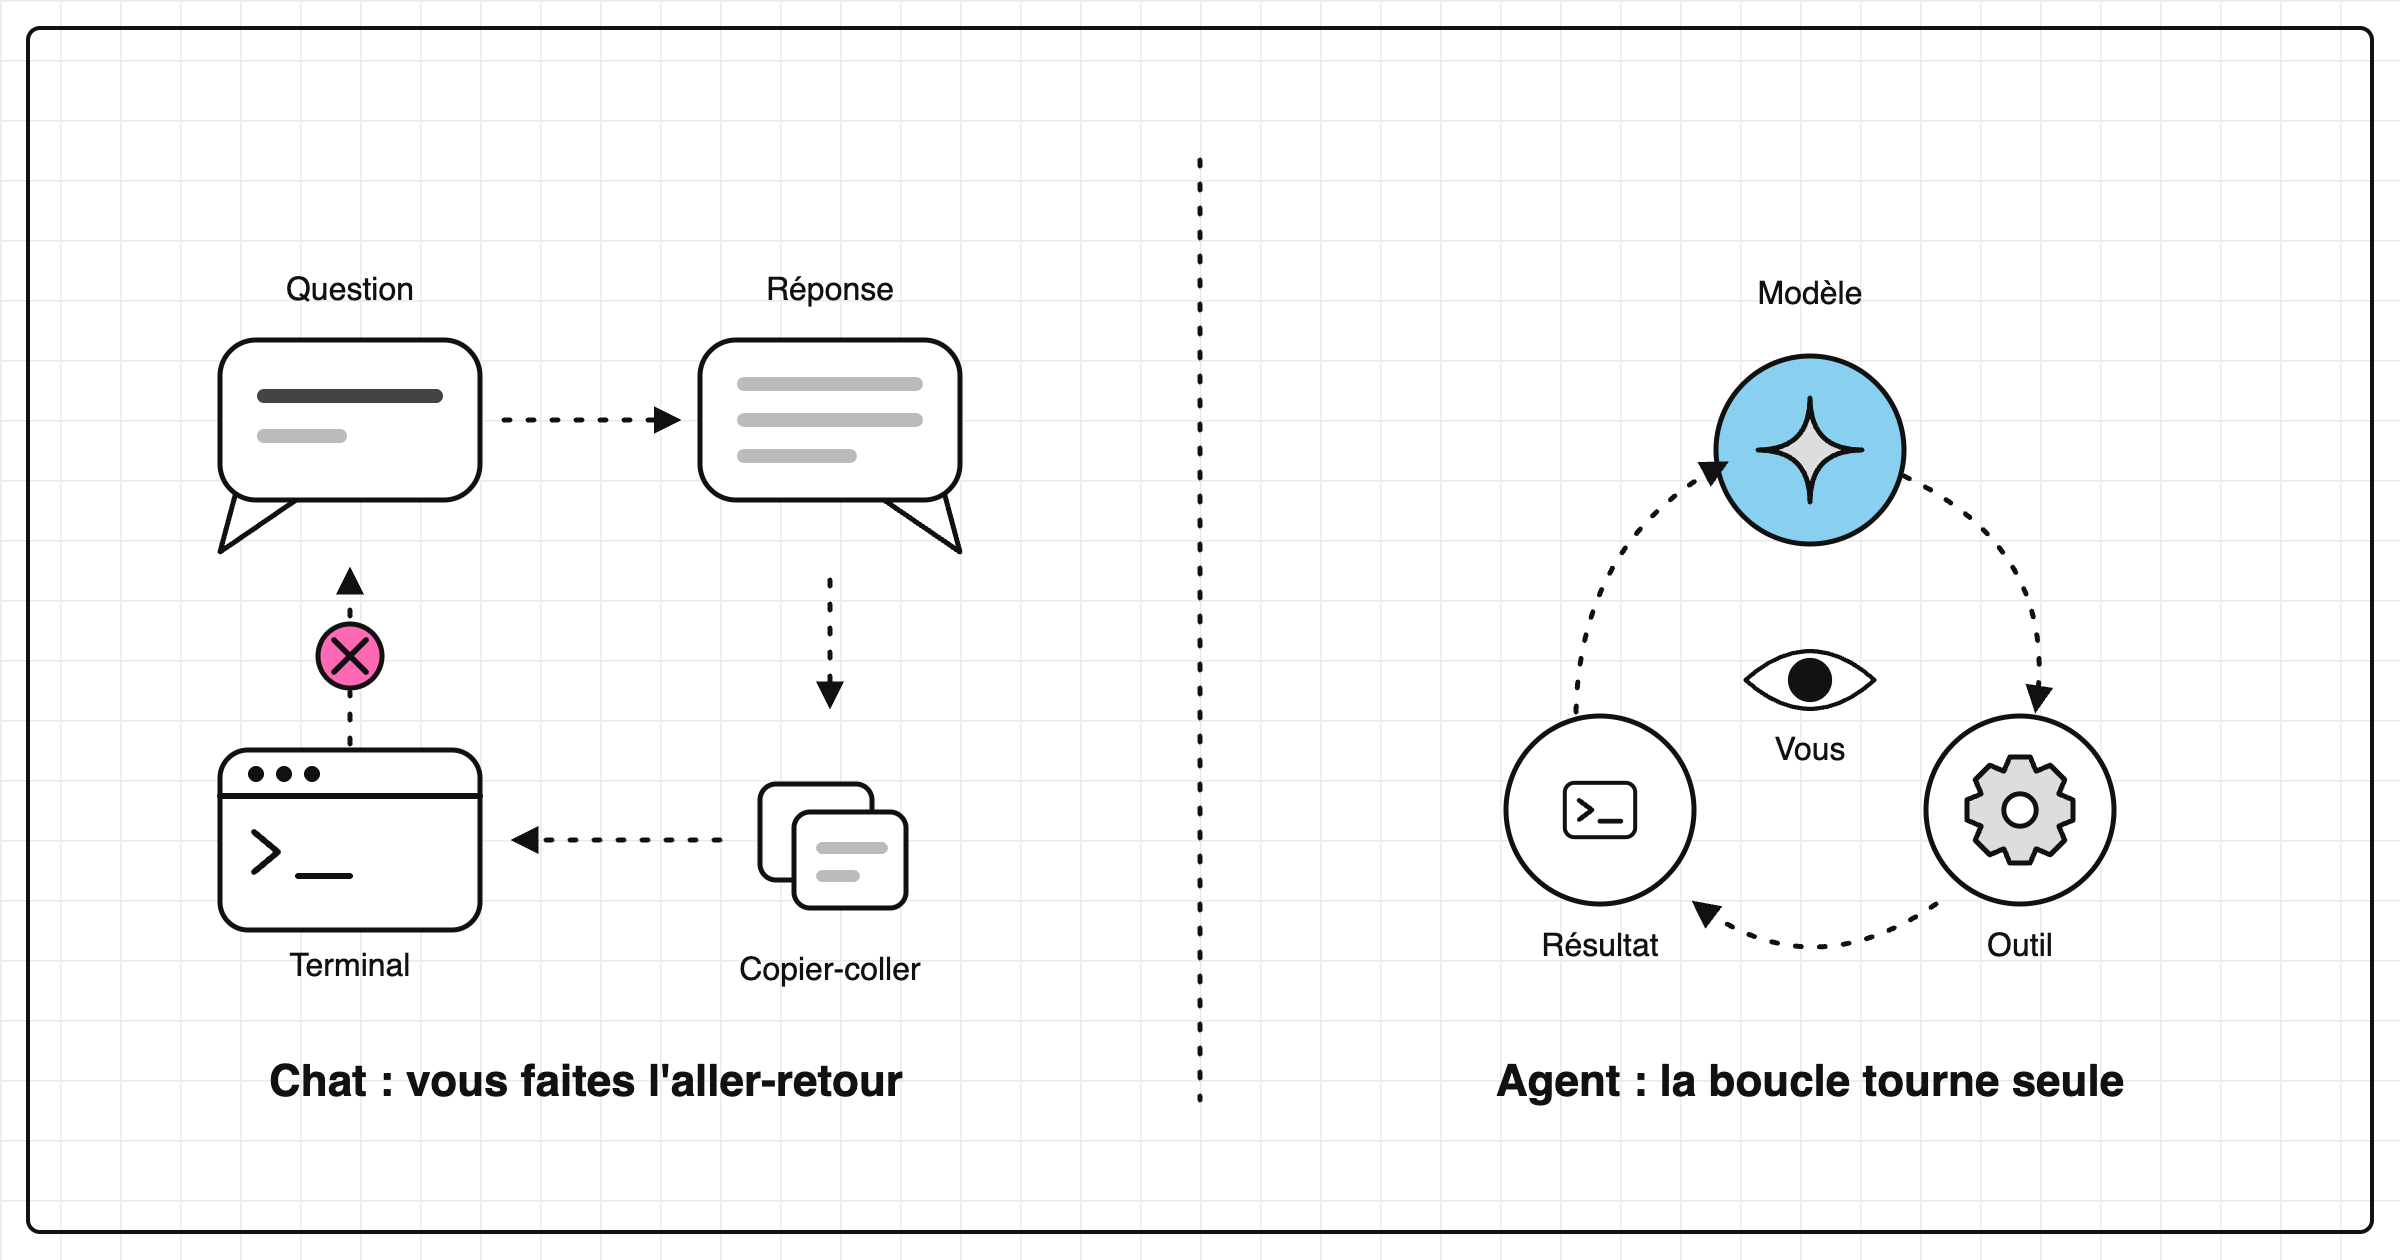
Un agent, c'est un modèle qui utilise des outils en boucle (agent loop). Après chaque action, il voit le résultat réel (sortie des tests, message d'erreur, contenu d'un fichier) et s'en sert pour décider de la suite. Il lance les tests, lit l'erreur, corrige, relance.
Avec un chat, c'est vous qui faites l'aller-retour entre la fenêtre de discussion et votre terminal. Franchement, c'est vite pénible.
Anthropic distingue deux approches :
- le workflow : des étapes prédéfinies dans le code guident le modèle, qui remplit les cases
- l'agent : le modèle dirige lui-même sa boucle et choisit ses actions.
Leur règle : la solution la plus simple d'abord. De la complexité seulement quand la tâche le demande. Claude Code est un agent, mais tout ne doit pas passer par lui. Une tâche répétitive et prévisible (lint, formatage, mise en prod) reste mieux servie par un script ou un job de CI : plus rapide, moins cher, parfaitement reproductible. Inutile de griller des tokens quand on peut automatiser.
| Besoin | Outil adapté | Pourquoi |
|---|---|---|
| Comprendre un concept, rédiger un message | Chat | Pas besoin d'accéder au repo |
| Compléter une ligne pendant que vous tapez | Autocomplétion de l'IDE | Latence minimale, vous restez aux commandes |
| Tâche sur plusieurs fichiers, tests à relancer | Agent | Boucle action → résultat réel |
| Tâche répétitive et prévisible | Script ou CI | Reproductible, gratuit, rapide |
| Tâche d'agent à automatiser (revue de PR, triage) | Agent sans interaction dans la CI | Même agent, sans vous dans la boucle |
Un environnement pour bien fonctionner
Le modèle reçoit du texte et renvoie du texte. Il raisonne, mais ne lit pas votre disque et n'exécute rien de lui-même… sauf s'il s'entoure d'outils.
Harness
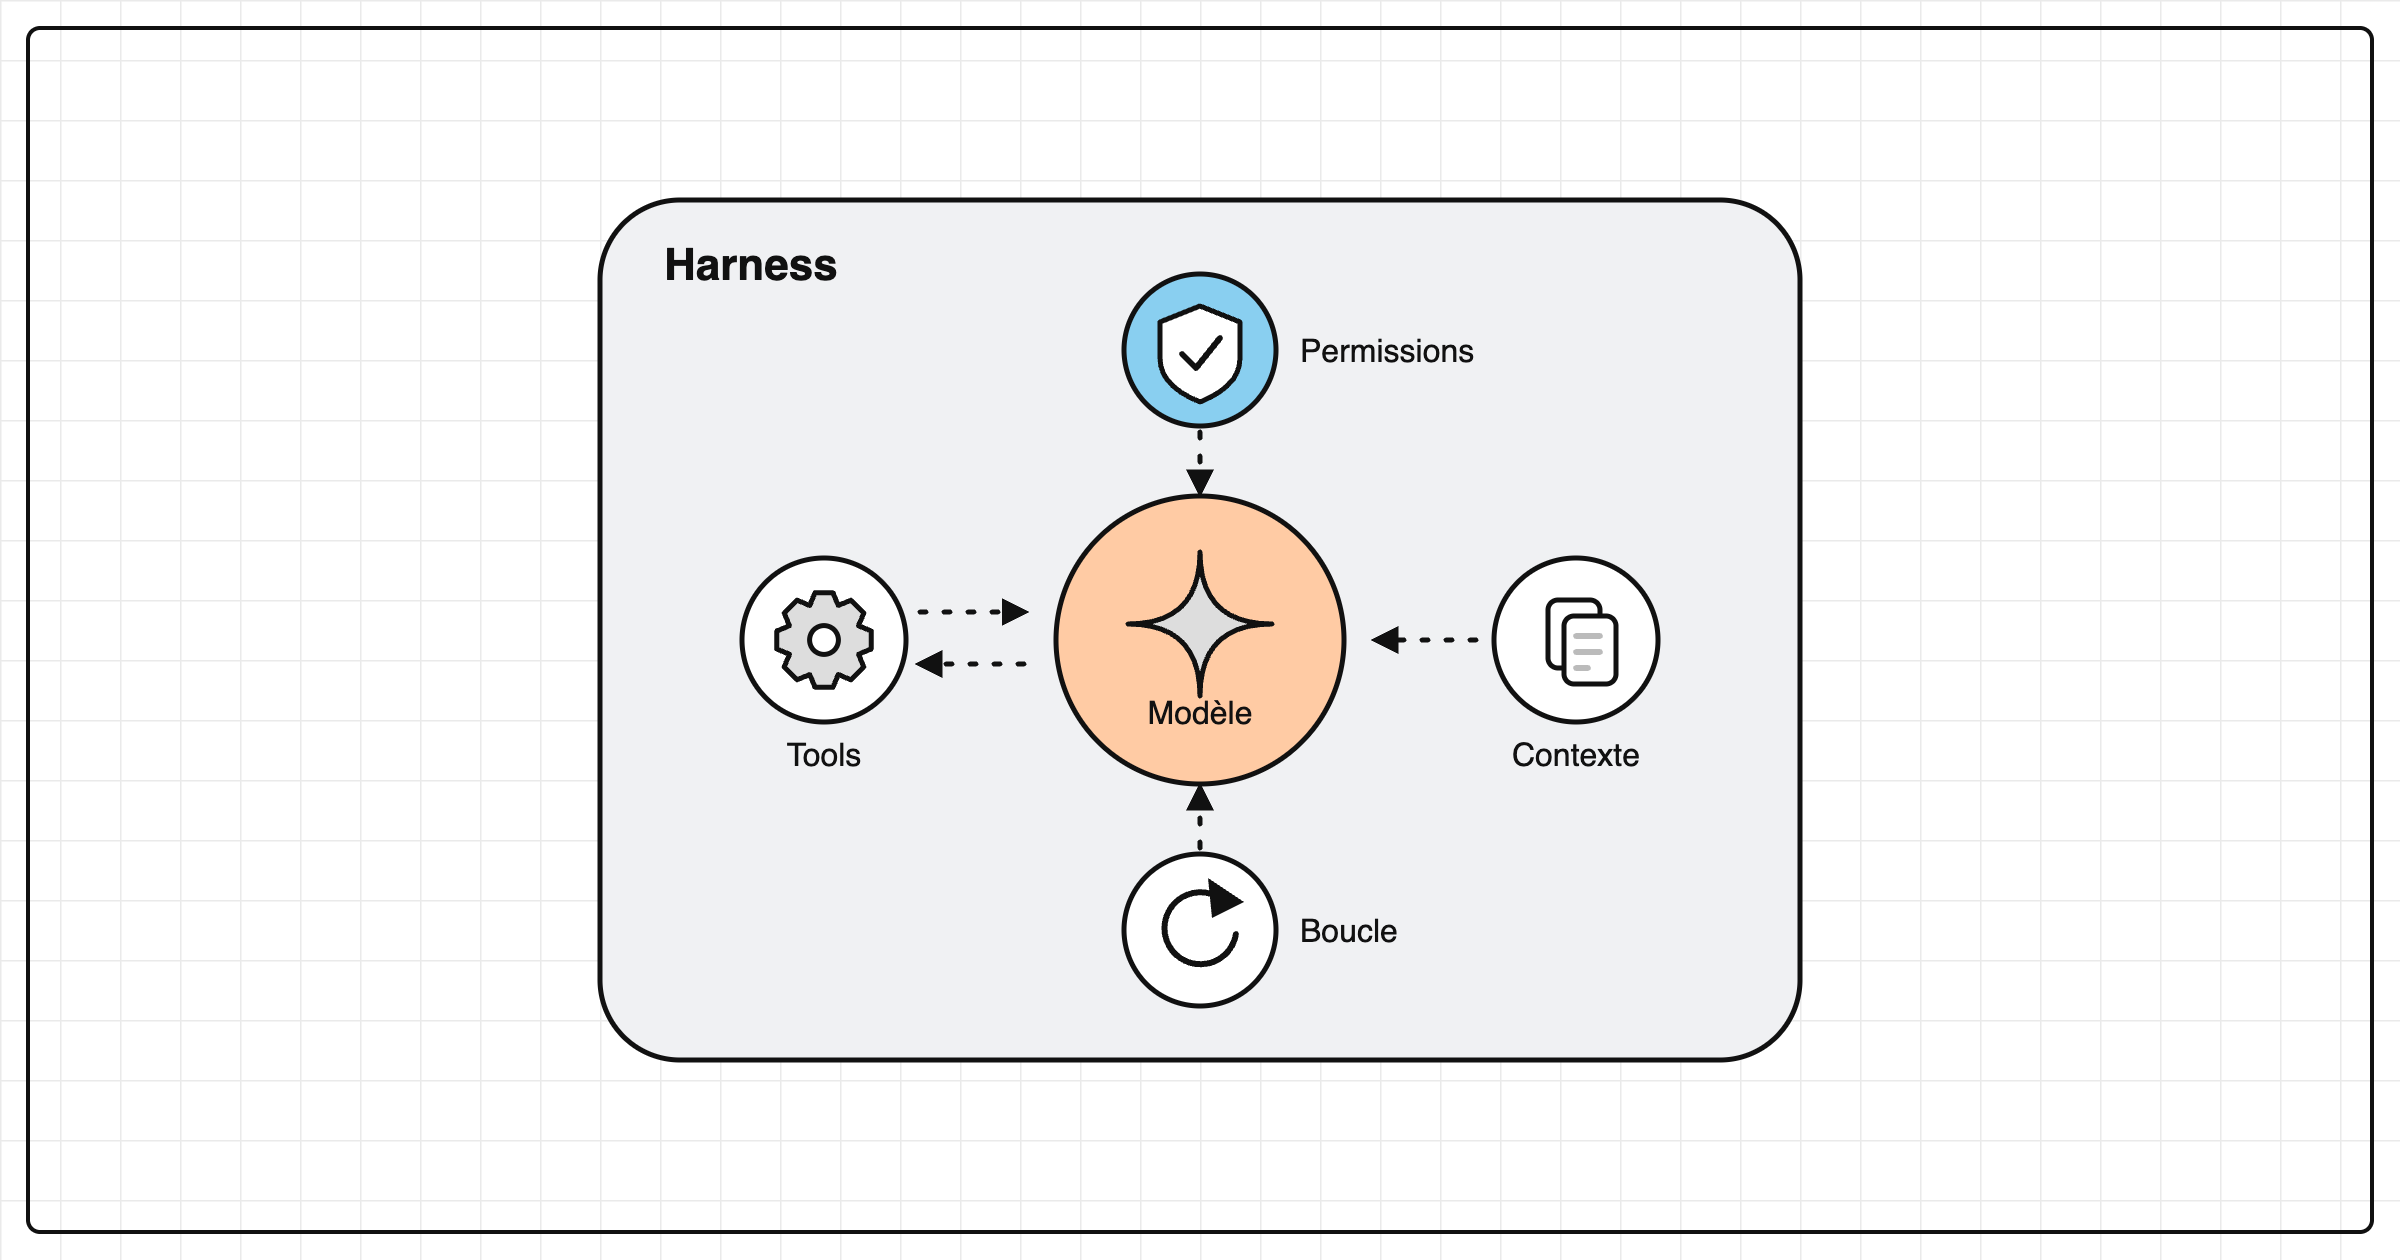
C'est tout le logiciel autour du modèle : la boucle qui l'appelle, les permissions, la gestion du contexte, les conditions d'arrêt. Quand le modèle veut lire un fichier ou lancer une commande, il ne peut que le demander. C'est le harness qui s'en charge.
Tools
Ce sont les actions que l'agent peut déclencher : lire et écrire des fichiers, lancer une commande, chercher dans le code, interroger le web. Sans eux, il ne reste qu'un chat.
Context
Ce que le modèle voit à chaque tour : votre prompt, l'historique, les fichiers lus, les sorties de commandes, le CLAUDE.md. Il est déjà en partie rempli avant votre premier message. Mal géré (trop long, peu précis…), il fait chuter la qualité, même avec un bon modèle.
La doc officielle parle d'agentic harness : Claude Code est la couche autour du modèle, celle qui fournit les tools et gère le contexte.
Périmètre d'action de l'agent
Conséquence directe : l'agent n'est jamais meilleur que ce qu'il peut observer et vérifier.
| Ce que ça couvre | Limite | |
|---|---|---|
| Ce qu'il sait | Langages, frameworks, conventions courantes (appris à l'entraînement) | Figé à une date : peut ignorer votre version d'une bibliothèque |
| Ce qu'il peut observer | Fichiers, sorties de tests, historique Git, pages web (via ses tools) | Seulement ce qu'il va chercher, et ce que le harness l'autorise à lire |
| Ce qu'il ne peut pas savoir | Décisions prises en réunion, contraintes métier non écrites, comportement réel en production | Rien, sauf si vous l'écrivez quelque part où il le lira |
Une bonne part du travail d'intégration consiste à déplacer des choses de la troisième ligne vers la deuxième.
Une session type : ajouter la pagination
Le ticket : ajouter la pagination à la liste des contacts.
Avec un prompt flou comme « ajoutez la pagination pour la liste des contacts », l'agent doit tout deviner. Quelle liste ? Combien d'éléments par page ? Quel format de réponse ? Quelle architecture respecter ? Seulement l'UI ou tout le pipeline jusqu'à l'API et aux tests ? Il explore large, touche des fichiers hors sujet et s'arrête quand le code lui semble correct.
Un prompt plus précis change la donne :
Ajoutez la pagination de la liste des contacts dans
ContactsViewModel.
20 contacts par page, page suivante chargée au scroll de la liste
paramètre
pagedeGET /contacts(à partir de 1, valeur par défaut 1)réponse en JSON, par exemple (
total= nombre total de contacts, pas de pages) :{ "items": [ { "id": 1, "name": "Alice Martin", "email": "alice.martin@example.com" }, { "id": 2, "name": "Bastien Roy", "email": "bastien.roy@example.com" } ], "page": 1, "pageSize": 20, "total": 57 }page hors limites : liste vide
erreur réseau ou
400: état d'erreur exposé par le view model, la liste déjà chargée reste affichéerespectez l'architecture MVVM existante et ne touchez à aucun autre écran
Le test
ContactsViewModelTestsdoit passer. Ajoutez les cas « page vide » et « erreur réseau », puis lancez la suite complète (xcodebuild test).
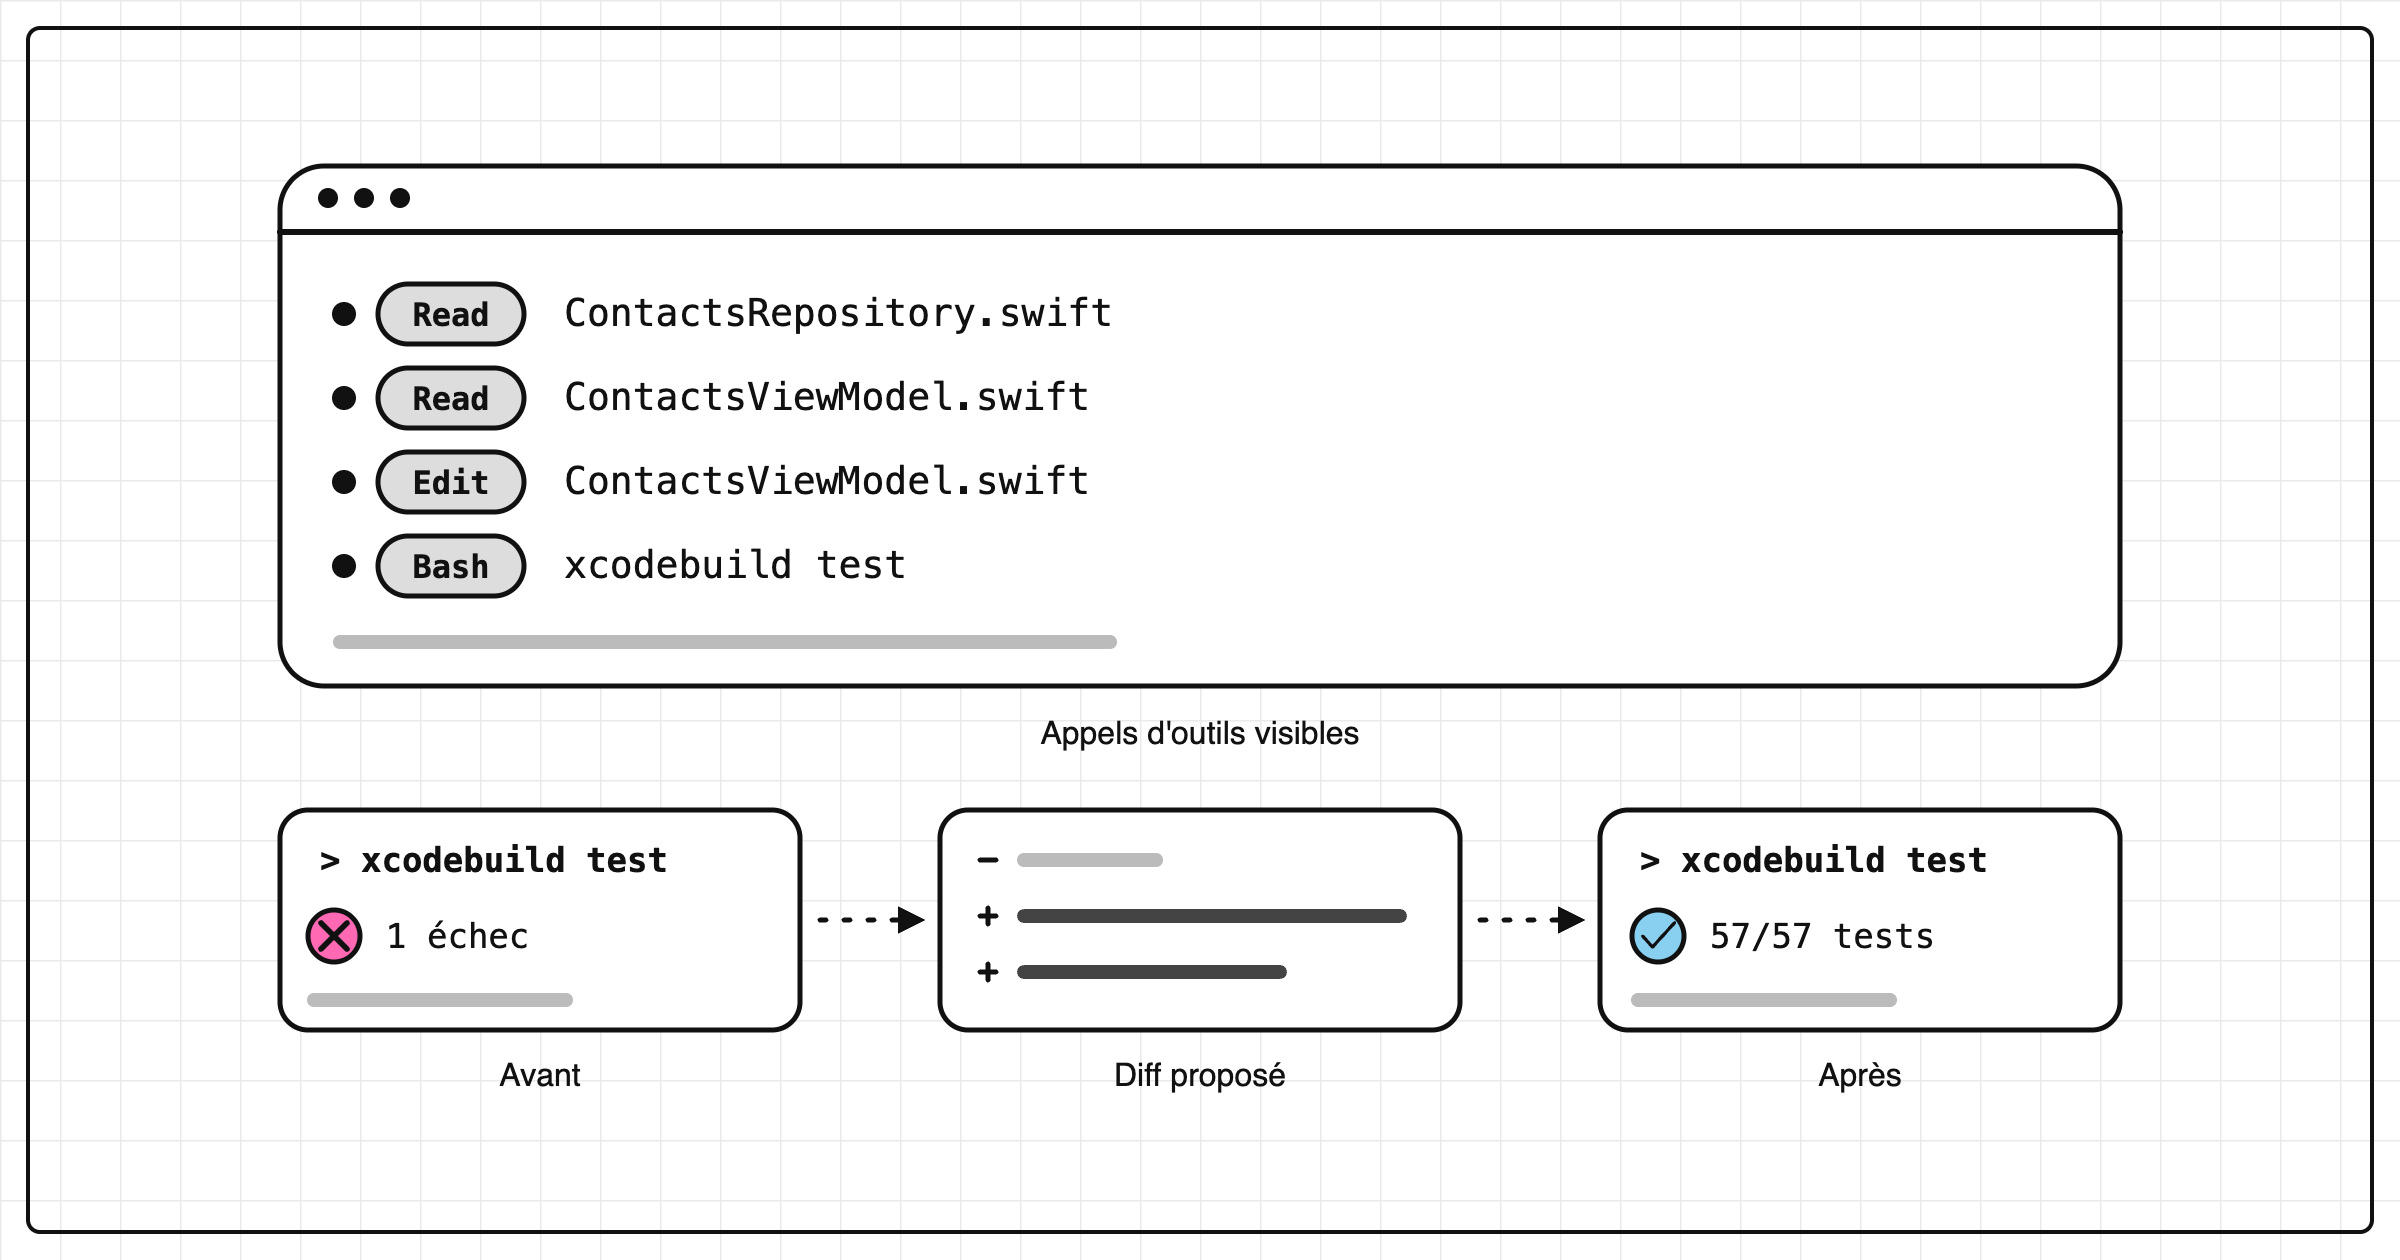
La session ressemble alors à ceci. Chaque étape est un tour de la boucle de l'agent (observer → décider → agir → vérifier) :
- Observer : l'agent lit
ContactsRepositorypuisContactsViewModelqui l'appelle. - Agir / vérifier : il lance le test, qui échoue. Le view model charge les 57 contacts d'un coup. Ce résultat réel lui dit quoi corriger.
- Décider / agir : il ajoute la limite et le numéro de page dans le view model. Le harness affiche le diff et demande votre accord (selon le mode de permission).
- Nouveau tour : il relance le test. Échec encore : le champ
totalmanque. Il l'ajoute. - Condition d'arrêt : le test passe. Il lance la suite complète pour vérifier qu'il n'a rien cassé ailleurs, puis s'arrête et résume ses modifications.
Avec un chat, vous auriez copié-collé chaque réponse en l'adaptant à votre projet. Ici, tout a été développé directement dans vos fichiers. Vous avez validé chaque modification et relu le diff final.
Le prompt précis donne à l'agent un critère de réussite qu'il peut vérifier lui-même. Donc un moyen de savoir quand s'arrêter.
Ce qui peut mal tourner
Un agent n'est pas magique. Certaines erreurs reviennent souvent :
- Un diff peut sembler correct et avoir tout faux : ça compile, les tests passent, mais le comportement n'est pas celui attendu (surtout si les tests ne couvrent pas le cas).
- L'agent peut inventer une API : une fonction ou un paramètre qui n'existe pas dans votre version de la bibliothèque.
- La boucle peut tourner en rond : la même correction tentée trois fois, sans nouvelle information.
- La portée peut dériver : un bugfix devient un refactoring de dix fichiers et votre partenaire vous quitte.
- Il peut annoncer « c'est fait » sans la moindre vérification, yolo ✌️.
Ces erreurs ont un point commun : elles passent inaperçues quand on se fie au résultat sans le vérifier. Les études vont dans ce sens. Dans le sondage Stack Overflow 2026, 87 % des répondants accordent une forme de confiance à l'IA, mais seulement 48 % quand ils peuvent vérifier le résultat. Et dans l'essai randomisé de METR, des développeurs expérimentés ont mis 19 % de temps en plus avec l'IA, alors qu'ils avaient l'impression d'en gagner 20 %. À nuancer : 16 développeurs, outils de début 2025, et METR n'a pas réussi à refaire la mesure de façon fiable depuis. Reste que l'impression de gagner du temps ne prouve rien.
Pour creuser le sujet : mon article sur la productivité de l'IA en 2026.
Pourquoi le prompt ne suffit pas
Retour à la machine à sous : le réflexe courant, c'est « je dois mieux reformuler ma demande, je vais écrire un roman avec le moindre détail, comme ça aucune erreur possible ». Ça aide un peu. Mais le problème est ailleurs.
Si le harness est flou, si les tools sont bruyants ou si le contexte déborde, le meilleur prompt du monde ne vous évitera pas un diff qui a l'air correct et qui est faux.
Deux exemples. Anthropic a comparé, sur un même modèle (Claude Opus 4.5) et la même demande (un éditeur de jeux rétro en 2D), un agent seul et un harness complet. L'agent seul : 20 minutes, 9 $, un jeu dont les entités s'affichent mais ne réagissent à rien. Le harness complet : 6 heures, 200 $, un jeu jouable. Plus de vingt fois plus cher, mais la différence de qualité saute aux yeux.
Côté équipes, la recherche DORA décrit l'IA comme un amplificateur : elle renforce les organisations déjà performantes et aggrave les dysfonctionnements des autres. Ceux qui en tirent le plus sont ceux qui ont retravaillé leur organisation autour de l'outil.
Anthropic en tire une règle : chaque composant d'un harness encode une hypothèse sur ce que le modèle ne sait pas faire seul. Ces hypothèses se périment à mesure que les modèles progressent. Il faut donc les retester à chaque nouveau modèle. Anthropic fournit d'ailleurs une commande pour ça : elle met à jour le code et la config pour un nouveau modèle, et signale les prompts à revoir.
Garder la main avant tout
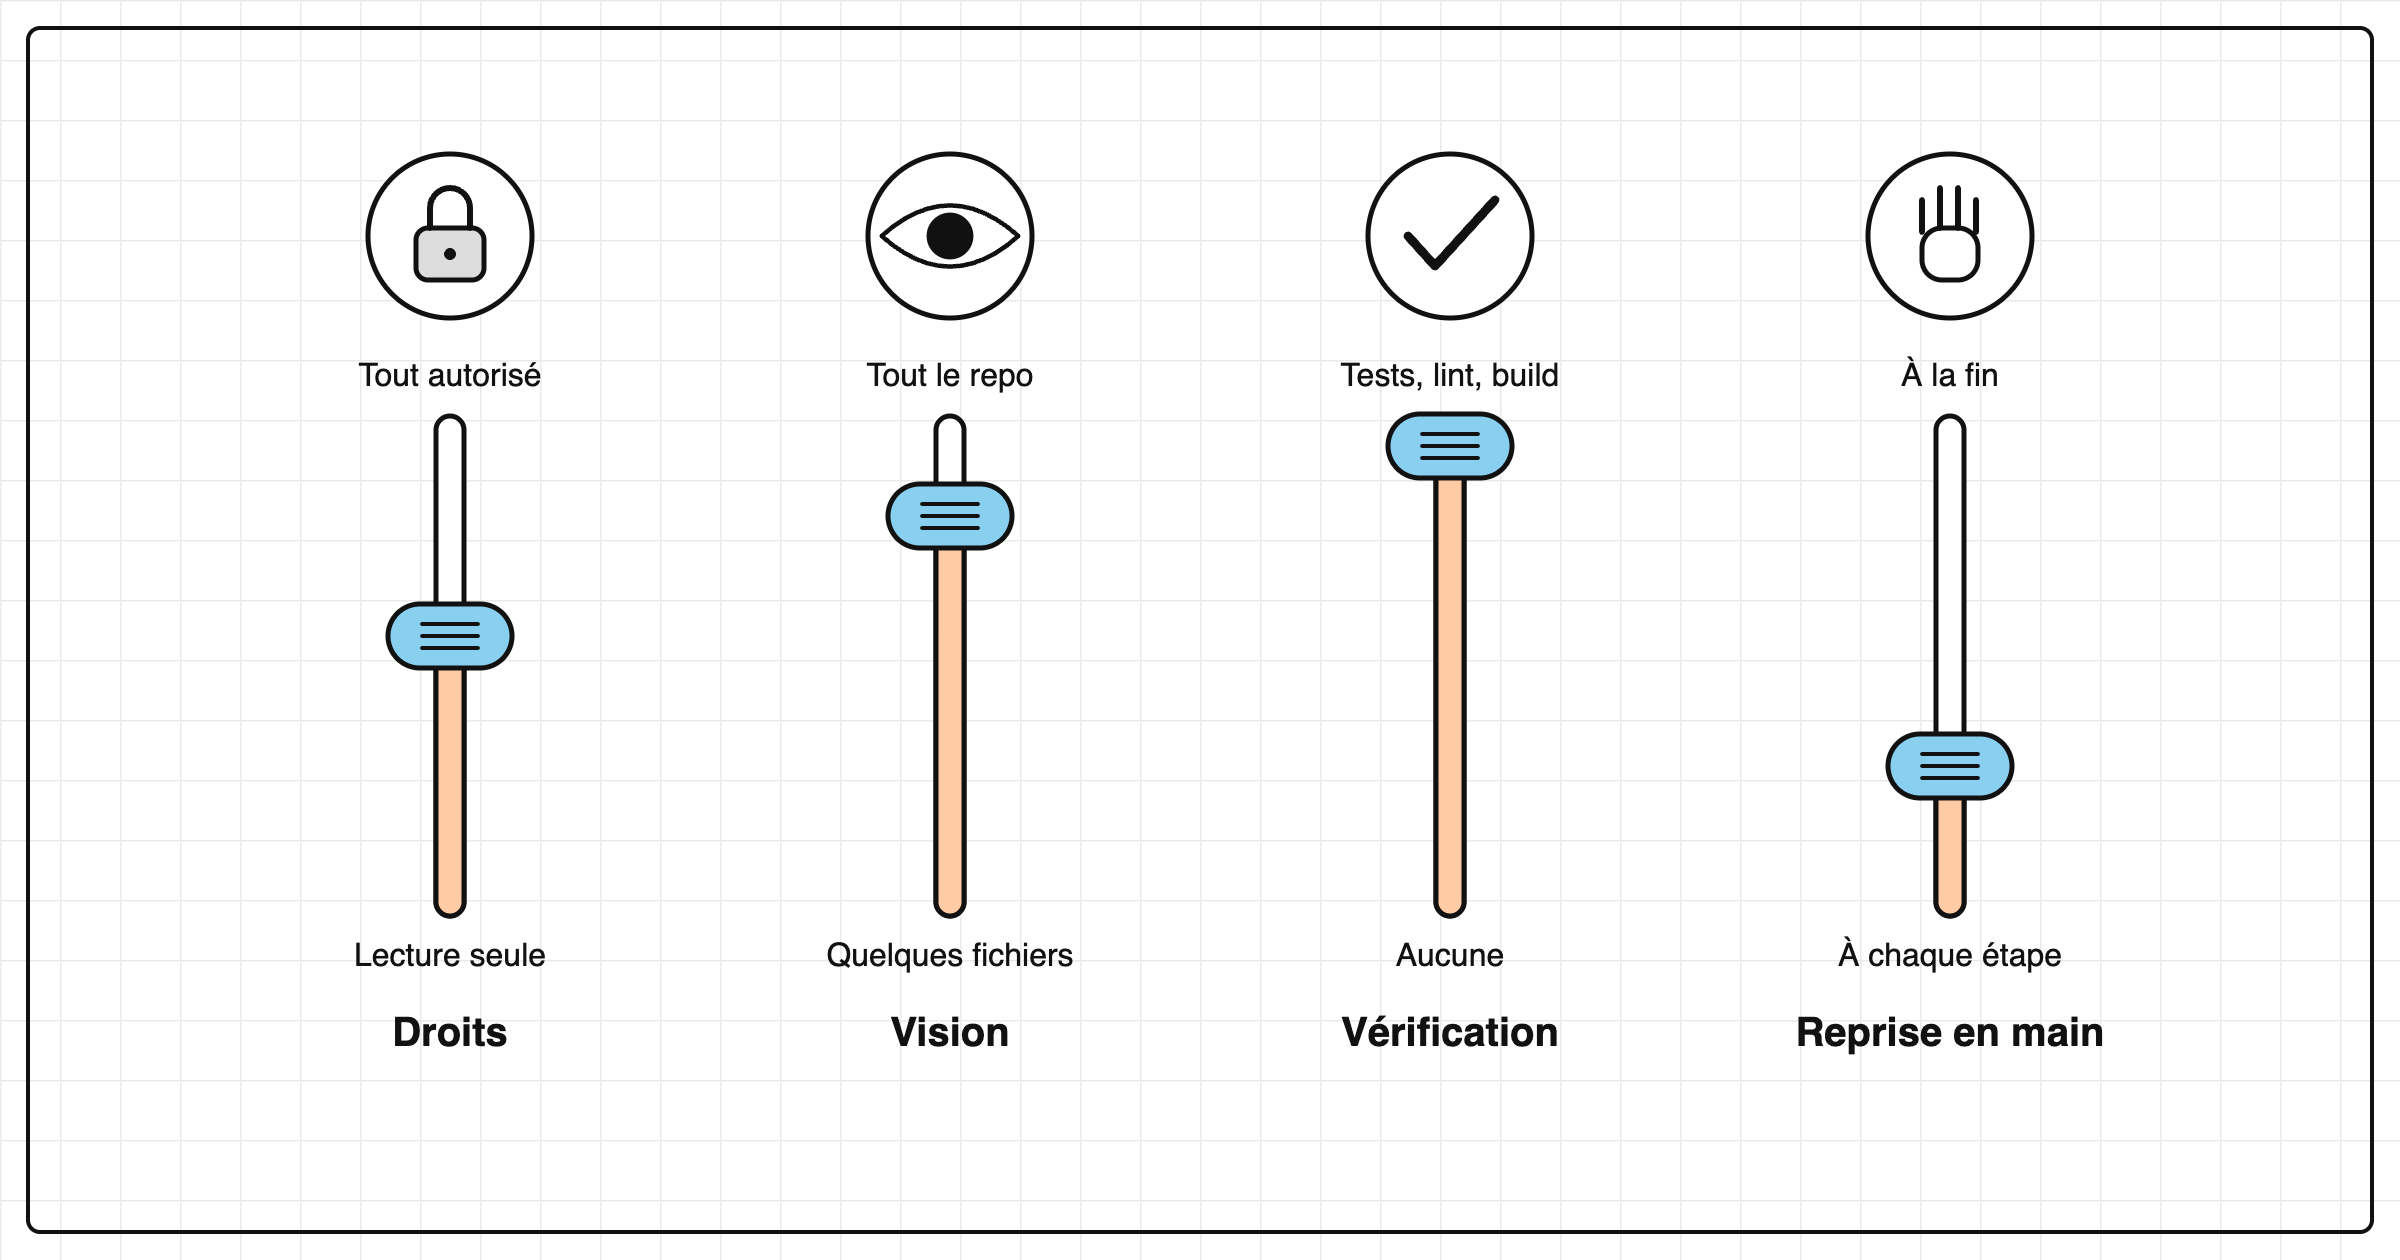
Intégrer un agent, c'est décider de quatre choses :
- Ce qu'il a le droit de faire → les permissions (réglées par le harness) : modifier des fichiers, installer une dépendance,
git push, déployer. - Ce qu'il voit → le contexte.
- Comment il vérifie son travail → tests, lint, build. Un agent qui ne peut pas vérifier son succès ne sait pas quand s'arrêter.
- Le moment où il vous rend la main → les conditions d'arrêt.
Côté permissions, Claude Code propose plusieurs modes, du plus prudent (vous validez chaque modification) au plus autonome (il agit seul, sous surveillance d'un second modèle), plus un mode plan en lecture seule, parfait pour explorer l'implémentation d'une fonctionnalité. Le mode sans aucune permission existe aussi : réservez-le à un conteneur isolé. Sinon pas la peine de venir poster sur Reddit le jour où il aura trouvé vos clés SSH. On détaille ces réglages dans l'article 6.
Et si l'agent part dans la mauvaise direction, vous pouvez revenir à un point de contrôle. Seules ses éditions de fichiers sont annulées : une commande comme rm reste exécutée. Gardez donc Git comme filet ; on y revient dans l'article 4.
Questions pour votre projet
- Quelles vérifications votre agent peut-il lancer seul aujourd'hui (tests, lint, build) ? Lesquelles lui manquent ?
- Quelle information importante sur votre projet n'existe que dans votre tête ou dans une réunion ?
- Sur votre dernière tâche confiée à une IA, combien d'allers-retours avez-vous faits vous-même entre le chat et le terminal ?
À retenir
- Un agent est un modèle qui utilise des tools en boucle et s'appuie sur le résultat réel de chaque action pour décider de la suite.
- La fiabilité dépend surtout du système autour du modèle (harness, tools, contexte), pas du prompt.
- Donnez-lui un critère de réussite qu'il peut tester lui-même. Sinon il ne saura pas quand s'arrêter.
Suite
Ce qui remplit votre fenêtre de contexte, et pourquoi la qualité des réponses baisse au fil d'une session.
Sources
- Stack Overflow, « 2026 Developer Survey » (octobre 2026) · survey.stackoverflow.co/2026
- Anthropic, « Building effective agents » (décembre 2024) · anthropic.com/research/building-effective-agents
- Documentation Claude Code, « How Claude Code works » · code.claude.com/docs/en/how-claude-code-works
- METR, « Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity » (juillet 2025) · metr.org ; « We are Changing our Developer Productivity Experiment Design » (24 février 2026) · metr.org
- Anthropic, « Harness design for long-running application development » (24 mars 2026) · anthropic.com/research/harness-design-long-running-apps
- DORA, « State of AI-assisted Software Development 2025 » (2025) · dora.dev/research/2025/dora-report
Certaines parties de cet article ont été écrites à l'aide d'une IA.